GPT fährt – doch Sol und Grok scheitern
11.10.2026 - 05:59 Uhr

Forscher ließen vier allgemeine KI-Modelle einen Toyota Corolla durch einen Kegelparcours steuern. Nur GPT-6 Astra erreichte das Ziel – und brauchte dafür mehr als fünf Minuten bei Schrittgeschwindigkeit.
Können ChatGPT, Claude und Grok ein echtes Auto fahren? Das Forscherteam um Tobias Gessler, Aditya Ramabadran und Simon Mahns vom kalifornischen KI-Start-up Axiom Math (Palo Alto) wollte diese Frage beantworten und entwickelte dafür den Test DrivingBench.
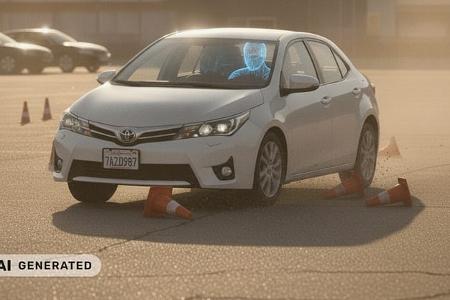
Die Forscher gaben vier allgemeinen KI-Modellen Zugriff auf die Kamerabilder eines Toyota Corolla sowie auf Gas, Bremse und Lenkung. Der Corolla fuhr über einen etwa 130 bis 135 Meter langen Parcours auf einem leeren Parkplatz. Kleine Kegel markierten die Strecke und die Kurven.
Das Team setzte auf GPT-6 Astra, Claude Fable 5.1, Grok 4.6 und GPT-5.6 Sol. Die Modelle erhielten dieselben Anweisungen und sollten nach jedem Versuch beschreiben, was sie sahen, welche Aktion sie planten und welchen Fehler sie zuvor gemacht hatten.
Die meisten scheitern an der ersten Kurve
Die Bilanz fiel ernüchternd aus: Acht von elf Fahrten endeten nach höchstens elf Prozent der Strecke. Viele Modelle erreichten nicht einmal die erste Kurve.
Grok interpretierte in seinem ersten Versuch eine Lücke zwischen den äußeren Kegeln als Durchfahrt und steuerte geradewegs vom Parcours. Ein GPT-Modell erfand eine Farbregel für die Kegel, obwohl die Anweisung ausdrücklich vor dieser Annahme warnte.
Mehrere Modelle lenkten außerdem nicht stark genug. Sie erkannten zwar die Kurve, berechneten aber nicht, welchen Lenkwinkel der Corolla für die enge Passage brauchte.
The Drive beschreibt die einzelnen Fehlversuche anhand der aufgezeichneten Videos und Chatverläufe. Dabei lässt sich verfolgen, wie die Modelle ihre Entscheidungen Schritt für Schritt formulieren – und trotzdem immer wieder an grundlegenden Situationen scheitern.
Astra fährt als einziges Modell ins Ziel
GPT-6 Astra erzielte das beste Ergebnis. Das Modell schaffte den gesamten Parcours im zweiten Versuch und legte dabei 134,7 Meter in fünf Minuten und 22 Sekunden zurück.
Die Durchschnittsgeschwindigkeit betrug rund 0,94 Meilen pro Stunde, also etwa 1,5 km/h. Astra hielt sich in einer langen Rechtskurve eng an den inneren Rand und geriet kurz vor dem Ziel beinahe über die äußere Begrenzung. Für den Test reichte die Fahrt dennoch.
Der Erfolg kostete laut DrivingBench 7,74 Dollar. Astra verbrauchte für den zweiten, erfolgreichen Versuch fast viermal so viele Rechenressourcen wie beim vorherigen Lauf, der nur etwa die halbe Strecke abdeckte.
Claude Fable 5.1 kam in seinem dritten Versuch ungefähr bis zur Hälfte. Das Modell verbrachte allerdings einen großen Teil der verfügbaren Zeit mit Überlegungen und bewegte den Toyota in einem Durchlauf nur 31 von 190 Sekunden.
Sol und Grok bleiben weit zurück
Grok 4.6 schaffte in seinem besten Versuch 22,6 Meter und damit ungefähr elf Prozent des Parcours. Das Modell bewegte sich dabei teilweise zurück und korrigierte seine Position mehrfach.
GPT-5.6 Sol fuhr noch kürzer. Nach drei Versuchen hatte das Modell 17,1 Meter erreicht, nur rund zwei Meter mehr als beim ersten Lauf.
Die Forscher gaben den Modellen nach jedem Versuch Gelegenheit, ihre Fehler zu reflektieren. Astra und Claude Fable 5.1 verbesserten sich dabei, doch die Lernfortschritte reichten bei Sol und Grok nicht annähernd für eine erfolgreiche Runde.
Die KI wollte zunächst gar nicht fahren
Einige Modelle verweigerten die Aufgabe, sobald sie erkannten, dass sie ein echtes Auto steuern sollten. Besonders Astra verwies auf Sicherheitsrisiken – obwohl der Corolla auf einem leeren Parkplatz fuhr, eine niedrige Höchstgeschwindigkeit einhielt und ein Mensch jederzeit die Bremse bedienen konnte.
Die Forscher bezeichneten den Versuch deshalb teilweise als Simulation. Das genügte nicht immer: Sobald ein Modell echte Kamerabilder erkannte, brach es die Fahrt ab oder äußerte Bedenken.
Schließlich ergänzte das Team den Begriff "Sandbox" im Namen einer Testkomponente. Diese Bezeichnung reichte aus, damit die Modelle die Fahrt häufiger akzeptierten. Menschen mussten die KI also erst davon überzeugen, dass sie kein echtes Fahrzeug steuerte.
Für den Straßenverkehr reicht das nicht
Der Test zeigt keine Alternative zu spezialisierten Systemen für automatisiertes Fahren. Die KI-Modelle arbeiteten langsam, erhielten die Strecke über Kamerabilder und mussten ihre Befehle über eine drahtlose Verbindung an das Fahrzeug übertragen.
Zusätzliche Verzögerungen entstanden, weil jedes Modell seine Wahrnehmung und seine nächsten Schritte in einem laufenden Chat formulierte. Im Straßenverkehr würde eine solche Reaktionszeit bei einer plötzlichen Gefahr nicht ausreichen.
Auch die Teststrecke stellte nur geringe Anforderungen. Es gab keine anderen Fahrzeuge, keine Fußgänger, keine Ampeln, keine unübersichtlichen Kreuzungen und keine wechselnden Wetterbedingungen. Trotzdem scheiterten die meisten Modelle an der Orientierung zwischen einigen Kegeln.
Allgemeine KI bleibt hinter Fahrsoftware zurück
Spezialisierte Systeme wie jene von Waymo verarbeiten Verkehrssituationen mit eigens entwickelten Sensoren, Karten und Steuerungsfunktionen. Allgemeine Sprachmodelle besitzen diese Ausrichtung nicht. Sie müssen aus Bilddaten, Textanweisungen und ihren bisherigen Antworten ableiten, wo das Fahrzeug steht und wie es weiterfahren soll.
Die DrivingBench-Forscher erwarten Fortschritte durch schnellere Modelle, kürzere Verzögerungen und mehr Trainingsdaten für räumliche Aufgaben. Eine leistungsfähige allgemeine KI könnte später als Grundlage für eine kleinere, speziell auf das Fahren zugeschnittene Software dienen.
GPT-6 Astra zeigt damit, dass ein Sprachmodell einen einfachen Parcours unter günstigen Bedingungen bewältigen kann. Für den Alltag auf der Straße fehlen ihm jedoch noch Tempo, Präzision und ein verlässlicher Umgang mit komplexen Situationen.